Voor het Surelock Red Team zijn we continu bezig met het verbeteren en uitbreiden
van de technische capaciteiten. Intern wordt veel onderzoek gedaan en de resultaten
van deze onderzoeken willen wij graag delen. Het vergroten van kennis zorgt
namelijk ook voor het vergroten van awareness.
Het onderwerp wat bij dit eerste artikel centraal staat is de zogenaamde agent die
gebruikt wordt tijdens de simulaties. De agent is het programma wat wordt
geïnstalleerd op een doelsysteem om van afstand acties uit te kunnen voeren.
Hiermee kan gecontroleerd het gedrag van malware gesimuleerd worden.
Om een zo breed mogelijk spectrum aan malware en de bijbehorende acties te
kunnen simuleren, was het nodig om onze agent uit te breiden. Het probleem hierbij is dat het toevoegen van functionaliteiten kan zorgen voor een grotere voetafdruk, wat de kans op detectie verhoogt. Daarom is er gezocht naar een modulaire oplossing, om nog steeds alle geavanceerde functionaliteiten uit te kunnen voeren, zonder dat dit te veel impact heeft op de voetafdruk van de agent.
De optie die hier het beste uit de bus gekomen is, is het uitvoeren van zogenaamde Object Files. Deze methode is gekozen met de volgende overwegingen:
Genoeg redenen om dit te onderzoeken en te implementeren in de agents van Surelock.
Een Object File, ook wel Common Object File Format (COFF), is een bestand wat gegenereerd wordt door een compiler tijdens het compileren van een programma. Meerdere Object Files worden vervolgens aan elkaar verbonden door een linker om het uiteindelijke programma te genereren:
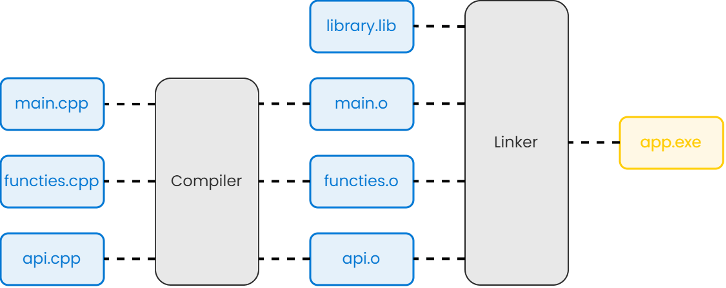
De compiler zet de code om in individuele object files. Deze object files maken gebruik van bijna dezelfde structuur als een executable (.exe); het Portable Executable (PE) formaat. Het enige verschil is dat een object file een extra symbol tabel heeft.
Deze symbol tabel bevat de namen van alle externe variabelen die gebruikt worden door het object. Bijvoorbeeld, wanneer de code in main.cpp gebruik maakt van een functie uit functies.cpp genaamd functie1, zal deze geregistreerd staan in de symbol tabel van main.o.
De functie staat dus wel geregistreerd binnen main.o, het object weet alleen niet op welke locatie deze functie te vinden is. De linker zorgt er voor dat deze functies het correcte adres krijgen in de uiteindelijke PE app.exe.
Wanneer we een object file willen uitvoeren, moeten we er voor zorgen dat we net als een linker de symbol tabel kunnen verwerken naar de daadwerkelijke locatie van de functies. Hiervoor moeten we eerst de structuur van een COFF begrijpen, dus de structuur van een PE.
Een Portable Executable is het formaat wat Windows gebruikt voor programma’s. Het bevat verschillende sections met alle data die nodig is om het programma uit te voeren. Deze sections zijn gestructureerd aan de hand van de zogenaamde headers. De headers bepalen bijvoorbeeld hoe groot de specifieke sections zijn, en waar ze te vinden zijn in memory.
Als we een PE onder de loep nemen met PE-bear, zien we dat deze bestaat uit meerdere sections:
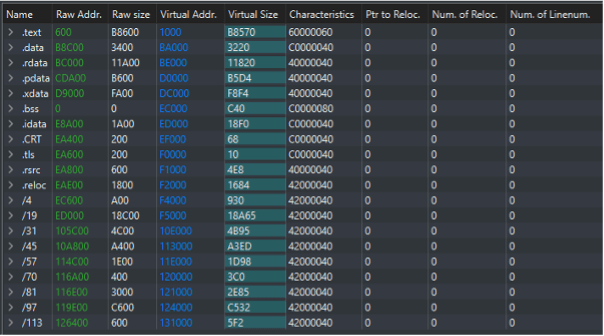
Een aantal relevante sections voor dit onderzoek zijn:
Tijdens het uitvoeren van de PE moet er voor gezorgd worden dat alle verschillende functies en variabelen uit de sections te vinden zijn. We nemen het volgende simpele C programma als voorbeeld:
#include <stdio.h>

char cVoorbeeld[12] = "Surelock\n";

int main(void) {
      printf("%s", cVoorbeeld);
}
Wanneer we dit uitvoeren binnen een debugger zoals IDA, zien we dat het omgezet is naar de volgende machine code:
.text:00007FF7DAA11000 main proc near
.text:00007FF7DAA11000 sub     rsp, 28h
.text:00007FF7DAA11004 lea     rdx, cVoorbeeld
.text:00007FF7DAA1100B lea     rcx, Format
.text:00007FF7DAA11012 call    printf
.text:00007FF7DAA11017 nop
.text:00007FF7DAA11018 xor     eax, eax
.text:00007FF7DAA1101A add     rsp, 28h
.text:00007FF7DAA1101E retn
.text:00007FF7DAA1101E main endp
Waar cVoorbeeld verwijst naar het volgende adres in de .data section:
.data:00007FF7DAA31000 cVoorbeeld db 'Surelock',0Ah,0En Format naar:
.data:00007FF7DAA3100C Format db '%s',0De code uit de .text sectie verwijst dus naar de globale variabelen in .data aan de hand van de locatie in memory. Hierbij is ook te zien dat de compiler een globale waarde aanmaakt voor de "%s" waarde, welke door IDA correct geïnterpreteerd wordt als het format.
Maar wat nu als we het voorbeeldprogramma opsplitsen in twee bestanden? In bestand1.c hebben we de volgende code:
char cVoorbeeld[12] = "Surelock\n";En in bestand2.c hebben we de volgende code:
#include <stdio.h>
#include "bestand1.c"

extern char cVoorbeeld[12];

int main(void) {
     printf("%s", cVoorbeeld);
}
Als we bestand2.c compilen naar een object, maar niet linken, zien we het volgende wanneer we het disassemblen:
main:
0000000000000000: 48 83 EC 28        sub         rsp,28h
0000000000000004: 48 8D 15 00 00 00  lea         rdx,[cVoorbeeld]
                  00
000000000000000B: 48 8D 0D 00 00 00  lea         rcx,[$SG9917]
                  00
0000000000000012: E8 00 00 00 00     call        printf
0000000000000017: 90                 nop
0000000000000018: 33 C0              xor         eax,eax
000000000000001A: 48 83 C4 28        add         rsp,28h
000000000000001E: C3                 ret
Wanneer we vervolgens naar het adres van cVoorbeeld kijken zien we dat deze wijst naar 0x00000000 en dus leeg is. Als we naar de symbol table kijken bevestigen we dat cVoorbeeld aanwezig is als externe waarde:
> dumpbin bestand2.obj /SYMBOLS

Dump of file bestand2.obj

File Type: COFF OBJECT

COFF SYMBOL TABLE

[...]

009 00000000 SECT3  notype       External     | cVoorbeeld

[...]
Als we dit object uit willen voeren in memory, moeten we weten waar de locatie van deze functie is. Hiervoor implementeren we een Object Loader die we ook in onze agent kunnen gebruiken.
Het doel van de Object Loader is om een object bestand uit te lezen en deze uit te voeren in memory. Hiervoor moeten al de symbols verwerkt worden zodat ze wijzen naar het correcte adres in memory. Het kan dus eigenlijk gezien worden als een Linker die we verwerken in de agent.
Als we dit zelf willen implementeren moeten globaal de volgende stappen doorlopen worden:
In de komende secties worden deze stappen gegroepeerd verder toegelicht.
Om een COFF object te parsen moeten we eerst weten waar alle onderdelen te vinden zijn. Zoals eerder benoemd kunnen we dit bepalen aan de hand van de header. De specificatie van deze header is te vinden in de documentatie van Microsoft. In deze sectie is een poging gedaan om deze documentatie samen te vatten.
Een COFF bestand heeft de volgende structuur:
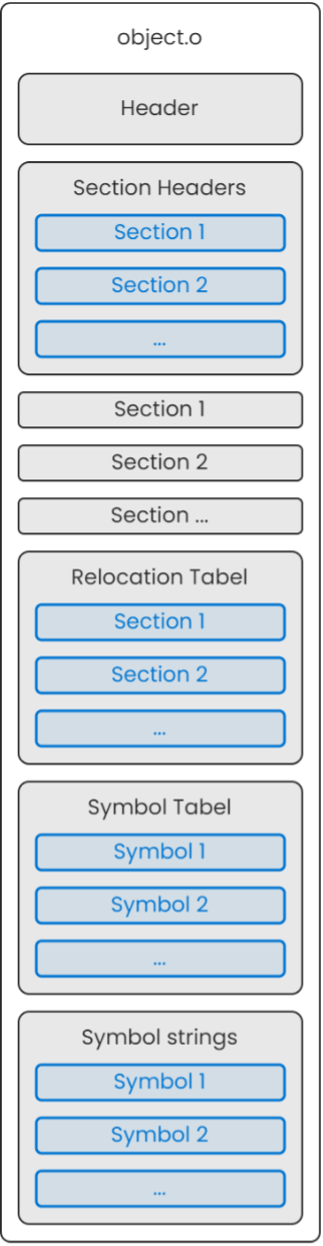
De header begint direct aan het begin van het bestand, dus bij memory offset 0. Vanuit daar volgen de volgende onderdelen:
Dus wanneer we toegang willen hebben tot de Symbol Table, kunnen we het adres op de volgende manier berekenen:
Basisadres in memory + PointerToSymbolTable
Na de COFF header krijgen we de section headers, deze headers bevatten informatie over de specifieke sections. Elke section header bevat de volgende informatie:
Als we tijdens het parsen toegang willen tot een van de section headers, kunnen we daar de volgende waardes voor gebruiken:
Basisadres in memory + grootte van COFF header + grootte van section header * Nummer van de
section header die we willen parsen
Of als we direct bij de data in de section willen, kunnen we het volgende gebruiken:
Basisadres in memory + PointerToRawData van de section
De Relocation Tabel bevat informatie over hoe de data in de sections aangepast moet worden om in memory geladen te kunnen worden. Voor elke section bestaat een array, waar elke waarde de volgende informatie bevat:
Dit kan gebruikt worden om te bepalen wat uiteindelijk het absolute adres is van een symbol binnen het hele object:
Absolute adres van een symbol = Adres van de symbol tabel + SymbolTableIndex * De Offset
gebaseerd op het Type
Vervolgens kan het relatieve adres tot de section bepaald worden met:
Relatieve adres van een symbol = Absolute adres van een symbol - Absolute adres van de section
De Symbol Tabel bevat alle data die we nodig hebben over de specifieke symbols. Het bevat een array met voor elke symbol de volgende data:
Met de waarde van de StorageClass kunnen we bepalen waar de symbol zich moet bevinden. Wanneer deze waarde bijvoorbeeld IMAGE_SYM_CLASS_EXTERNAL is bij een externe symbol, betekent dat het volgende volgens de Microsoft documentatie:
“De symbol is te vinden in een ander COFF object. Wanneer het sectienummer 0 is, zal de Value de grootte zijn van de symbol. Als het niet 0 is, is de Value het relatieve adres van de symbol.”
Dus aan de hand van de StorageClass weten we hoe we de Value kunnen gebruiken om het adres te berekenen.
Het laatste deel bevat de strings voor alle symbols, voor wanneer de naam van de symbol langer is dan 8 bytes en niet direct in de Symbol Tabel past.
Nu hebben we alle informatie die we nodig hebben om een COFF bestand te verwerken en in memory te mappen.
De sections bevatten alle data die we nodig hebben om het programma uit te voeren. We moeten deze sections parsen en de memory toewijzen.
We berekenen de benodigde grootte in memory door over alle aanwezige sections heen te loopen, en de SizeOfRawData op te vragen uit de header. Deze hoeveelheid memory kunnen we dan toewijzen als PAGE_READWRITE zodat we er naar kunnen schrijven.
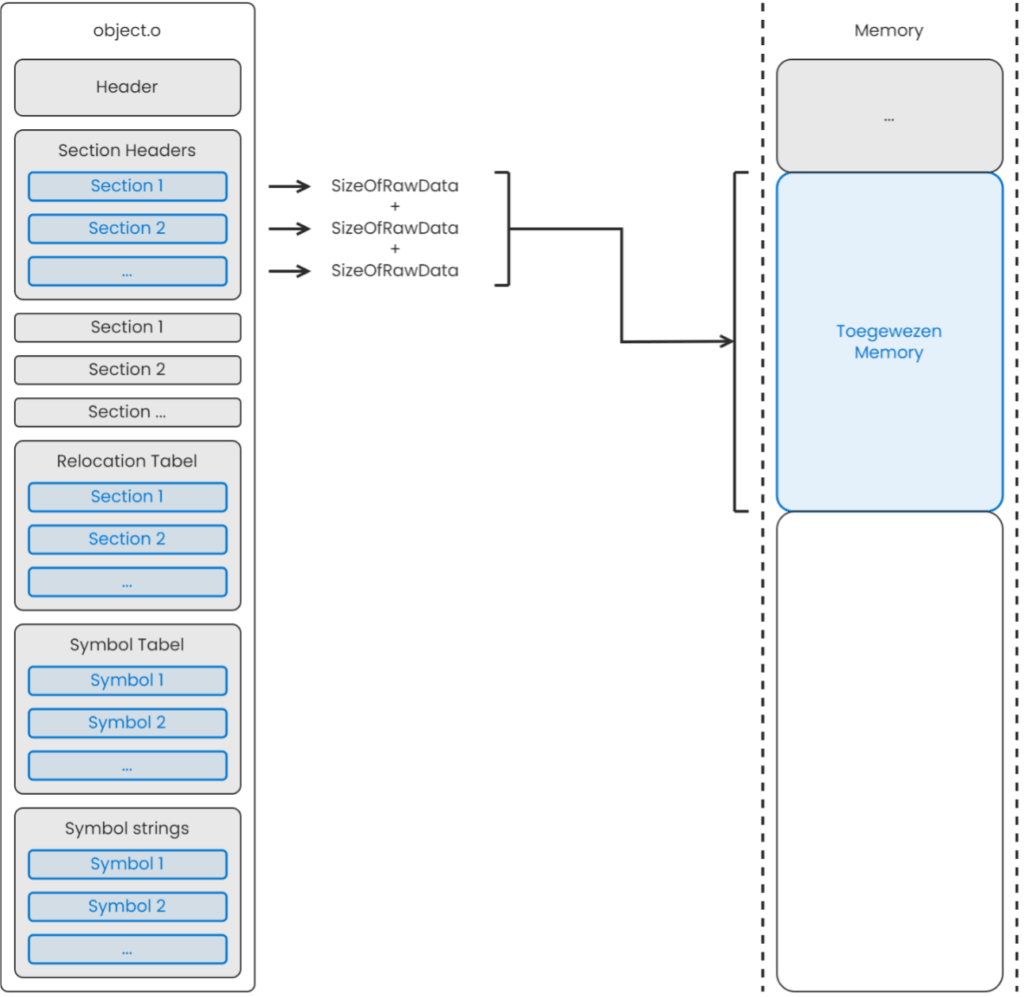
Vervolgens loopen we weer over alle sections en kopiëren we deze naar de toegewezen memory. We weten op welk adres de data zich bevindt aan de hand van de PointerToRawData en tot waar het loopt door hier de SizeOfRawData bij op te tellen.
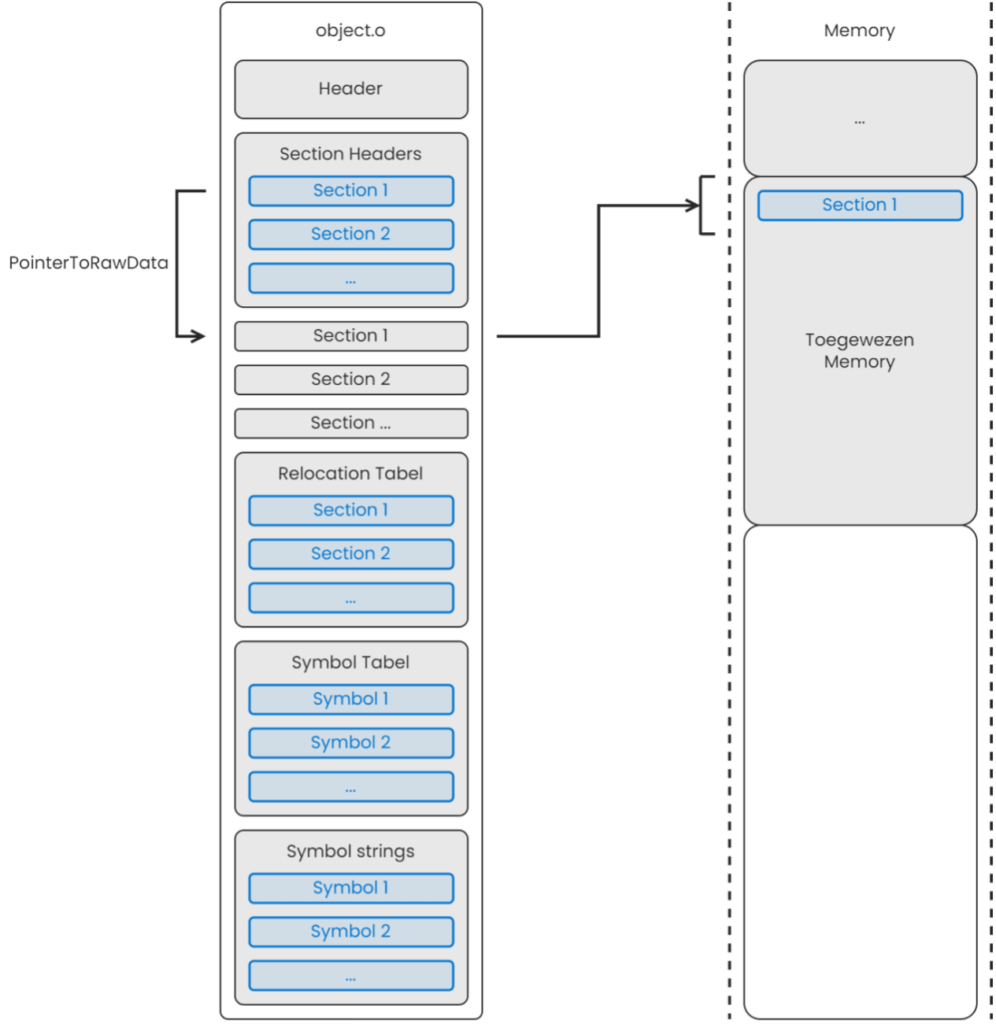
Naast de sections willen we ook de Symbol Tabel opslaan, zodat we bij kunnen houden welke functies we al verwerkt hebben. We weten hoeveel memory we hiervoor moeten toewijzen door voor elke section over de Symbol Tabel te loopen en te kijken of de functienaam begint met __imp_, wat betekent dat het een import is. We vragen hiervoor de Name value op van elke entry in de Symbol Tabel, als deze __imp_ bevat moeten we extra memory toewijzen ter grootte van PVOID, aangezien hier de function pointer in moet passen.
Nu de sections in memory geladen zijn willen we ervoor zorgen dat de functie adressen naar de correcte locatie wijzen.
Hiervoor loopen we weer over de geladen sections en vragen we alle function symbols op per section. Per symbol bepalen we vervolgens of het extern is en uit welke library het moet komen aan de hand van de string. Deze string ziet er bijvoorbeeld als volgt uit:
__imp_KERNEL32$GetCurrentProcessHier zien we als eerste de __imp_ tag, wat betekent dat dit een externe functie is. Vervolgens zien we KERNEL32, dit is de library waar de functie uit komt. Als laatste hebben we de functienaam zelf, wat in dit voorbeeld GetCurrentProcess is.
Voor interne functies kunnen we in de .text section kijken waar deze functie te vinden is. Voor externe functies is dit iets ingewikkelder. Hier moeten we de externe library inladen, waar we de locatie van de specifieke functie kunnen opvragen.
Op deze adressen willen we vervolgens de relocation toepassen, zodat we altijd het juiste adres hebben. Om dit uit te voeren hebben we per symbol het volgende nodig:
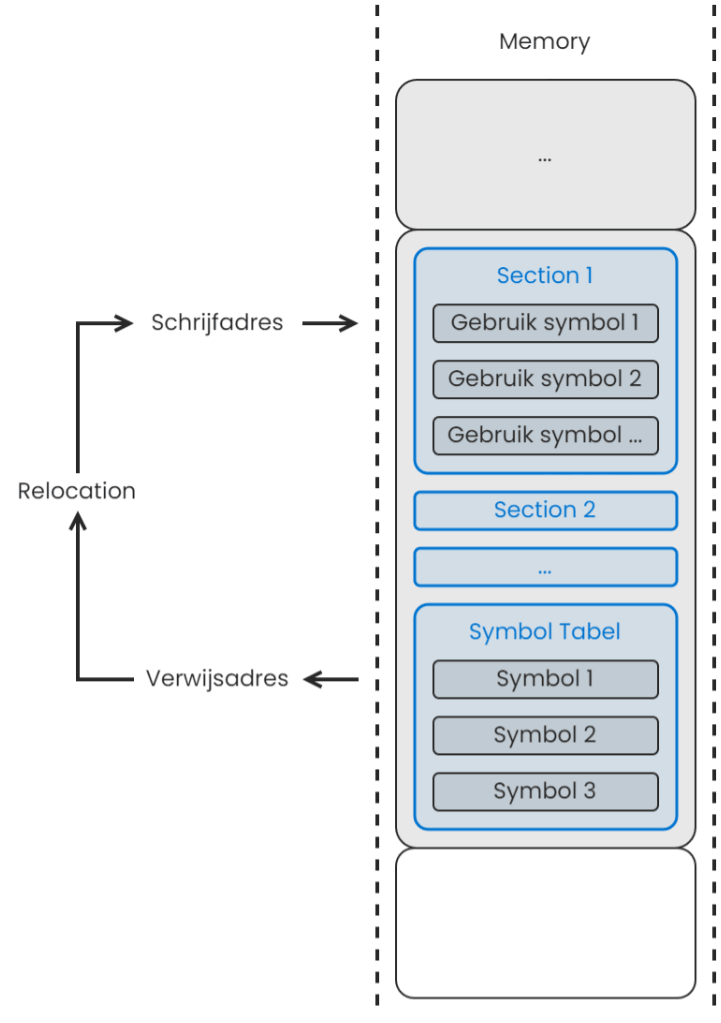
Het type relocation kan uit de relocation tabel gehaald worden, door de waarde voor Type op te vragen. Wat deze types betekenen staat uitgelegd in de Microsoft Documentatie.
Het adres waar de waarde geschreven moet worden, is de eerste byte in de section op de plek van de symbol die aangepast moet worden. Dit kan berekend worden gebaseerd op de COFF structuur:
Schrijfadres = VirtualAddress van de Section + VirtualAddress uit de relocation tabel voor de symbol
Het adres waar het naar moet verwijzen hangt af van het type relocation. Als het type bijvoorbeeld IMAGE_REL_AMD64_REL32 is, kan het als volgt berekend worden:
Verwijsadres = VirtualAddress van de Section + Relatieve adres in 32 bits van de symbolWanneer we het verwijsadres bepaald hebben, kunnen we deze kopiëren naar het schrijfadres. Als dit gedaan is voor alle sections en relocations, is het linken uitgevoerd. Nu is het mogelijk om het object in memory uit te voeren.
Om de object file uit te voeren moeten we de locatie van de startfunctie vinden. Als deze naam bijvoorbeeld “go” is, willen we zoeken in de geladen symbol tabel om deze functienaam te vinden. In deze tabel vinden we dan ook gelijk het adres wat we moeten hebben.
De memory van de functie moet uitvoerbaar gemaakt worden. Vervolgens casten we de locatie van de symbol naar een functie en voeren we deze uit.
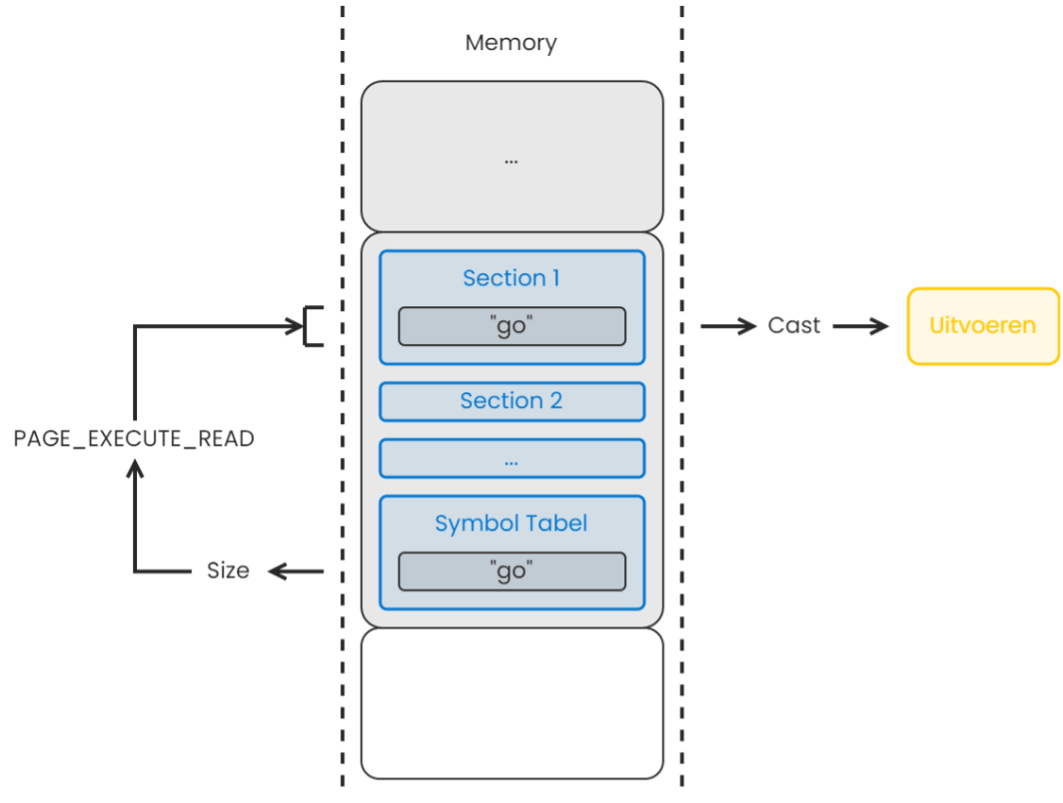
Wanneer alles correct geïmplementeerd is, zou het object uitgevoerd moeten worden.
Cobalt Strike en meerdere andere C2 platforms maken gebruik van zogenaamde Beacon Object Files (BOF). Deze BOF’s hebben een extra functionaliteit wat het mogelijk maakt om onder andere data van en naar de Object Files te schrijven.
Cobalt Strike heeft een header beschikbaar gesteld waar alle beschikbare functies in te zien zijn. Deze header is te zien in de documentatie. De bijbehorende functies kunnen we zelf implementeren, of we gebruiken de volledige implementatie van de API, beschikbaar gesteld door TrustedSec op GitHub.
Voor de meeste BOF’s moet in ieder geval de volgende functies beschikbaar zijn:
Deze functies moeten beschikbaar zijn binnen het programma waarmee de BOF uitgevoerd zal worden, in ons geval dus in de agent.
Net zoals de andere functies willen we ervoor zorgen dat de adressen te vinden zijn binnen de Object File wanneer deze in memory geladen wordt. Gelukkig kunnen we deze case vrij eenvoudig afvangen, aangezien ze allemaal beginnen met de “Beacon” string. Dit handelen we dan verder af op dezelfde manier als de andere functie symbols.
Surelock heeft deze methodes als standalone programma geïmplementeerd en toegevoegd aan de agents. Als voorbeeld werd het dir object uitgevoerd in een testomgeving. Dit object is afkomstig van de TrustedSec Situational Awareness BOF collectie. Dit object leest de bestanden in de gekozen locatie uit.
De bofloader wordt uitgevoerd, welke het dir object in memory injecteert en uitvoert.
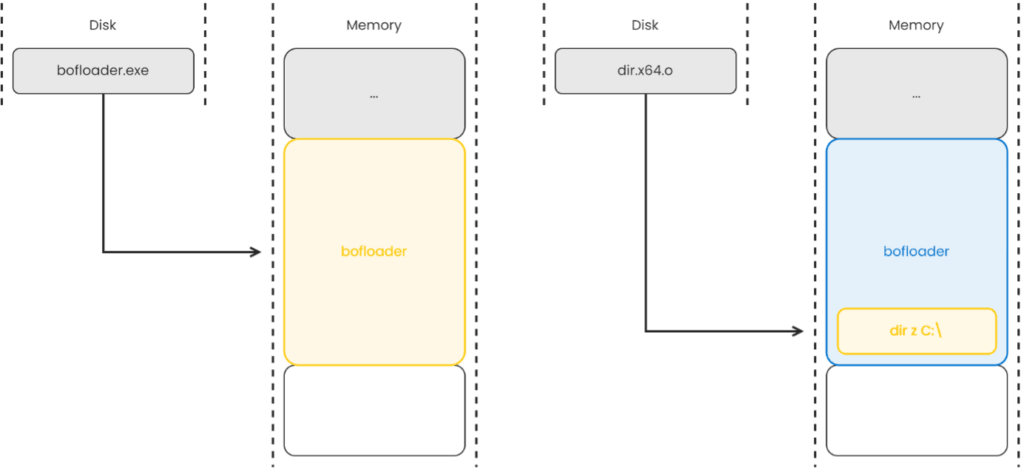
Dit gaf het volgende resultaat:
> .\bofloader.exe .\dir.x64.o z C:\

Geladen Object File: .\dir.x64.o
Virtual Size: 28672
Object file toegewezen op 00000285A6470000 met een grootte van 28672
Section .text - Adres: 00000285A6470000 - 2160 bytes gekopieerd
Section .data - Adres: 00000285A6471000 - 32 bytes gekopieerd
Section .bss - Adres: 00000285A6472000 - 0 bytes gekopieerd
Section .xdata - Adres: 00000285A6472000 - 144 bytes gekopieerd
Section .pdata - Adres: 00000285A6473000 - 132 bytes gekopieerd
Section .rdata - Adres: 00000285A6474000 - 208 bytes gekopieerd
Section /4 - Adres: 00000285A6475000 - 64 bytes gekopieerd
Section 0 heeft 85 relocations
KERNEL32$GetProcessHeap gevonden op locatie: 00007FFD94BD0DF0
KERNEL32$HeapAlloc gevonden op locatie: 00007FFD9568CB40
KERNEL32$GetProcessHeap gevonden op locatie: 00007FFD94BD0DF0
KERNEL32$HeapFree gevonden op locatie: 00007FFD94BD0D30
KERNEL32$GetProcessHeap gevonden op locatie: 00007FFD94BD0DF0
KERNEL32$HeapFree gevonden op locatie: 00007FFD94BD0D30
MSVCRT$calloc gevonden op locatie: 00007FFD950ECA70
BeaconOutput gevonden op locatie: 00007FF77B8614E0
MSVCRT$free gevonden op locatie: 00007FFD950ECAC0
MSVCRT$vsnprintf gevonden op locatie: 00007FFD9511E880
KERNEL32$GetProcessHeap gevonden op locatie: 00007FFD94BD0DF0
KERNEL32$HeapAlloc gevonden op locatie: 00007FFD9568CB40
KERNEL32$HeapFree gevonden op locatie: 00007FFD94BD0D30
Kernel32$WideCharToMultiByte gevonden op locatie: 00007FFD94BD0E30
KERNEL32$GetProcessHeap gevonden op locatie: 00007FFD94BD0DF0
KERNEL32$HeapAlloc gevonden op locatie: 00007FFD9568CB40
KERNEL32$HeapFree gevonden op locatie: 00007FFD94BD0D30
KERNEL32$GetProcessHeap gevonden op locatie: 00007FFD94BD0DF0
KERNEL32$HeapAlloc gevonden op locatie: 00007FFD9568CB40
MSVCRT$strlen gevonden op locatie: 00007FFD95132040
MSVCRT$_strnicmp gevonden op locatie: 00007FFD9512FC10
MSVCRT$strstr gevonden op locatie: 00007FFD95132900
MSVCRT$strcat gevonden op locatie: 00007FFD9512EF60
MSVCRT$strcmp gevonden op locatie: 00007FFD95131E40
MSVCRT$strcat gevonden op locatie: 00007FFD9512EF60
KERNEL32$FindFirstFileA gevonden op locatie: 00007FFD94BE06A0
KERNEL32$GetLastError gevonden op locatie: 00007FFD94BD0E10
BeaconPrintf gevonden op locatie: 00007FF77B861510
MSVCRT$strstr gevonden op locatie: 00007FFD95132900
MSVCRT$strcat gevonden op locatie: 00007FFD9512EF60
KERNEL32$FindClose gevonden op locatie: 00007FFD94BE0660
KERNEL32$FileTimeToSystemTime gevonden op locatie: 00007FFD94BE0B30
KERNEL32$SystemTimeToTzSpecificLocalTime gevonden op locatie: 00007FFD94BC2430
MSVCRT$strcmp gevonden op locatie: 00007FFD95131E40
MSVCRT$strlen gevonden op locatie: 00007FFD95132040
KERNEL32$GetProcessHeap gevonden op locatie: 00007FFD94BD0DF0
KERNEL32$HeapAlloc gevonden op locatie: 00007FFD9568CB40
MSVCRT$strncat gevonden op locatie: 00007FFD95132110
MSVCRT$strcat gevonden op locatie: 00007FFD9512EF60
KERNEL32$FindNextFileA gevonden op locatie: 00007FFD94BE0710
KERNEL32$GetLastError gevonden op locatie: 00007FFD94BD0E10
KERNEL32$FindClose gevonden op locatie: 00007FFD94BE0660
BeaconPrintf gevonden op locatie: 00007FF77B861510
KERNEL32$GetProcessHeap gevonden op locatie: 00007FFD94BD0DF0
KERNEL32$HeapFree gevonden op locatie: 00007FFD94BD0D30
BeaconDataParse gevonden op locatie: 00007FF77B861260
BeaconDataExtract gevonden op locatie: 00007FF77B8613F0
BeaconDataShort gevonden op locatie: 00007FF77B861350
KERNEL32$GetProcessHeap gevonden op locatie: 00007FFD94BD0DF0
KERNEL32$HeapAlloc gevonden op locatie: 00007FFD9568CB40
MSVCRT$strncat gevonden op locatie: 00007FFD95132110
KERNEL32$HeapFree gevonden op locatie: 00007FFD94BD0D30
Section 1 heeft 0 relocations
Section 2 heeft 0 relocations
Section 3 heeft 0 relocations
Section 4 heeft 33 relocations
Section 5 heeft 0 relocations
Section 6 heeft 0 relocations

Contents of C:\*:
        07/21/2025 02:34         <dir> $Recycle.Bin
        02/20/2026 03:12             0 $WINRE_BACKUP_PARTITION.MARKER
        02/22/2024 00:33        112136 appverifUI.dll
        07/31/2024 19:59    <junction> Documents and Settings
        03/16/2026 02:14         12288 DumpStack.log.tmp
        08/11/2025 05:48         <dir> inetpub
        03/16/2026 02:14    1342177280 pagefile.sys
        05/06/2022 22:24         <dir> PerfLogs
        09/26/2025 06:40         <dir> Program Files
        07/31/2024 15:06         <dir> Program Files (x86)
        09/26/2025 07:07         <dir> ProgramData
        07/21/2025 11:30         <dir> Recovery
        03/16/2026 02:14      16777216 swapfile.sys
        10/02/2025 07:26         <dir> Symbols
        07/31/2024 13:01         <dir> System Volume Information
        07/21/2025 04:59         <dir> Temp
        07/21/2025 02:32         <dir> Users
        02/22/2024 00:34         66328 vfcompat.dll
        02/20/2026 05:53         <dir> Windows
                            1359145248 Total File Size for 6 File(s)
                                                          13 Dir(s)
In de debug output is te zien dat alle symbols afgehandeld worden en uiteindelijk de BOF correct uitgevoerd wordt. Hoe deze implementatie precies in zijn werk gaat, zal misschien in een toekomstig artikel verder toegelicht worden.
De functionaliteit is toegevoegd aan de C2 agent. In combinatie met de andere bestaande functionaliteiten, kunnen nu object files als data gedownload en in memory geïnjecteerd worden. Dit maakt de agent modulair en zorgt ervoor dat de objecten geen voetafdruk achterlaten op de schijf van het systeem. Daarnaast kunnen we nu BOF’s gebruiken van Cobalt Strike, waar al een brede ondersteuning voor is.

 Vragen? Bel gerust naar 0348 796 146
